ByteByteGo《Top 6 Cost Optimization Strategies in AI Systems》导读:AI 系统成本优化六策
来源:ByteByteGo(Alex Xu),X 帖《Top 6 Cost Optimization Strategies in AI Systems》,2026-11-02。原文:https://x.com/alexxubyte/status/2117302471156781430 本篇是导读 + 重绘图;清单第 52 份,组七 Agent Ops。上方是矢量重绘(文字可选中、可任意缩放),下方附 ByteByteGo 原图供对照。
一句话结论
调用大模型最烧钱的地方往往不是模型本身,而是每次调用时重复花的冤枉钱:六条打法——提示词缓存、模型路由、批量接口、语义缓存、精简上下文、用小模型——分别从缓存、路由、批量、复用、瘦身、换小模型六个方向省。
为什么值得看
这是一张速查表,不是一篇长文。六条每条一句话,合起来就是一张 AI 系统成本优化的全图:跟清单里已有的选型/成本内容(比如 Hamel 的决策模型)互补,不重复;跟 AI FinOps 方向和 thinktank 的成本意识都咬合。读的时候不用逐条精读,对着自己的系统逐条过一遍,哪条没做、哪条能做,就够了。
| # | 策略 | 流程 | 省在哪 |
|---|---|---|---|
| 1 | Prompt Caching 提示词缓存 |
固定前缀只算一次,重复请求不再为同一段提示词付费。 | |
| 2 | Model Routing 模型路由 |
简单问题走便宜的小模型,难题才上前沿模型。 | |
| 3 | Batch API 批量接口 |
大批量任务异步处理,换更低的批量价,不必逐条实时调用。 | |
| 4 | Semantic Cache 语义缓存 |
相似问题直接复用已有答案,省一次模型调用。 | |
| 5 | Trim the Context 精简上下文 |
只送当次查询需要的上下文,不再每轮重发全部历史。 | |
| 6 | Go Smaller 用小模型 |
窄任务用蒸馏量化后的小模型,成本大降、准确率基本不丢。 |
原图对照
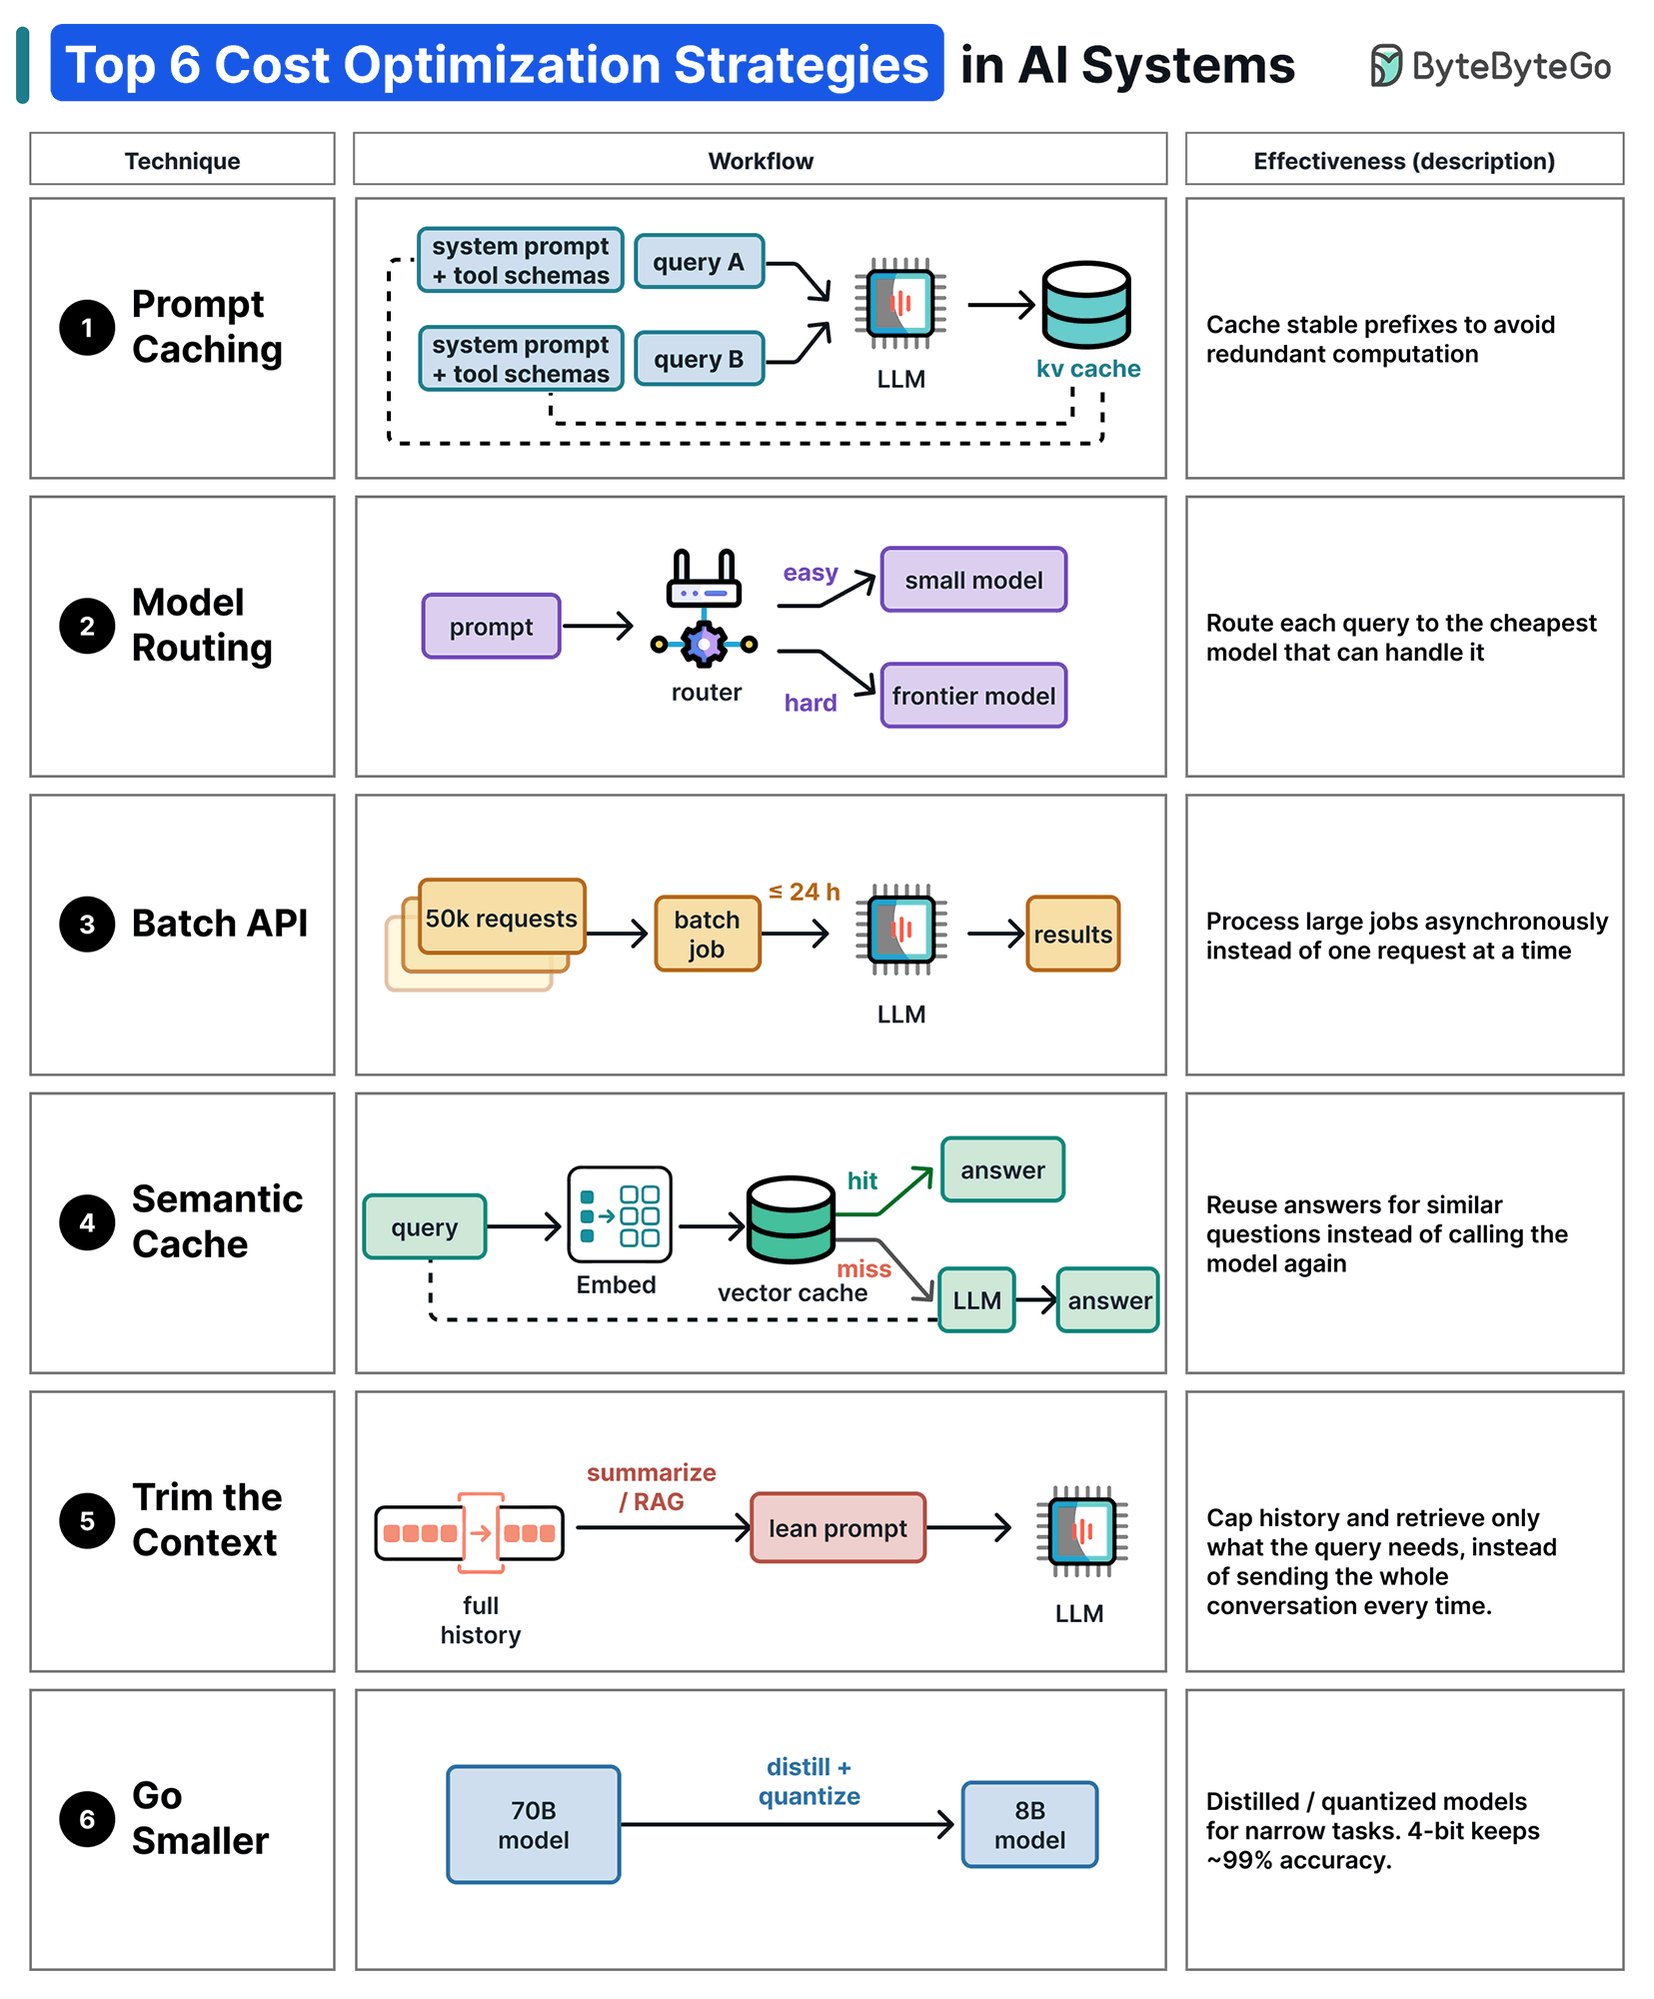
原图:ByteByteGo(Alex Xu)2026-11-02 X 帖附图(GIF 大图)。重绘版与原图逐条对照:流程步骤一致,重绘版把每条的效果说明改写为中文,并删去了原图的品牌配色与动画。
来源:ByteByteGo(Alex Xu)2026-11-02 X 帖《Top 6 Cost Optimization Strategies in AI Systems》,原帖。原图为 ByteByteGo 的 GIF(见上方原图对照);重绘版六条策略与流程步骤忠实原图,效果说明改写为中文;删去原图品牌配色与动画。4-bit 约保留 99% 准确率是原图说法,适用于窄任务,不宜外推到所有任务。